Giriş
Şirket içi dokümanlar, prosedürler, ürün notları ve sözleşme şablonları çoğu zaman farklı klasör ve sistemlere dağılır. Bir çalışan doğru belgeyi bulmak için zaman harcar; bir sohbet botu ise şirketin güncel politikasını bilmeden akıcı fakat yanlış bir yanıt üretebilir. RAG, bu iki sorunu aynı anda çözmeyi hedefleyen bir mimari yaklaşımıdır: Model yanıt üretmeden önce ilgili kurumsal bilgi parçalarını arar, bulunan parçaları bağlama ekler ve yanıtı bu bağlamla üretir.
RAG, İngilizce Retrieval-Augmented Generation ifadesinin kısaltmasıdır; Türkçede "getirimle zenginleştirilmiş üretim" olarak anılabilir. Kavramın temel akademik çalışması, önceden eğitilmiş bir üretici modeli dışarıdaki açık bir bilgi belleğiyle birleştirir; böylece modelin parametrelerinde saklı bilgiye tek başına güvenmek yerine, sorgu anında bulunan metinlerden yararlanır [1]. Kurumsal RAG'de bu dış bellek genellikle şirketin izinli doküman koleksiyonudur.
Bu fark kritiktir: RAG, bir modeli şirket verileriyle baştan eğitmek veya ince ayar yapmak değildir. Belgeler değiştiğinde bilgi tabanını güncellemek çoğu durumda yeterlidir; model ağırlıklarını yeniden eğitmek gerekmez. Ancak RAG "doğruluk garantisi" de değildir. Yanlış belge bulunursa, belge güncel değilse, erişim yetkileri yanlış uygulanırsa veya model kaynağın desteklemediği bir sonuç çıkarırsa sistem güvenilir görünse bile hatalı davranabilir. Bu nedenle RAG, yalnızca bir sohbet arayüzü değil, bilgi kalitesi, güvenlik, arama başarısı ve insan denetiminin birlikte tasarlanması gereken bir sistemdir.
RAG nasıl çalışır?
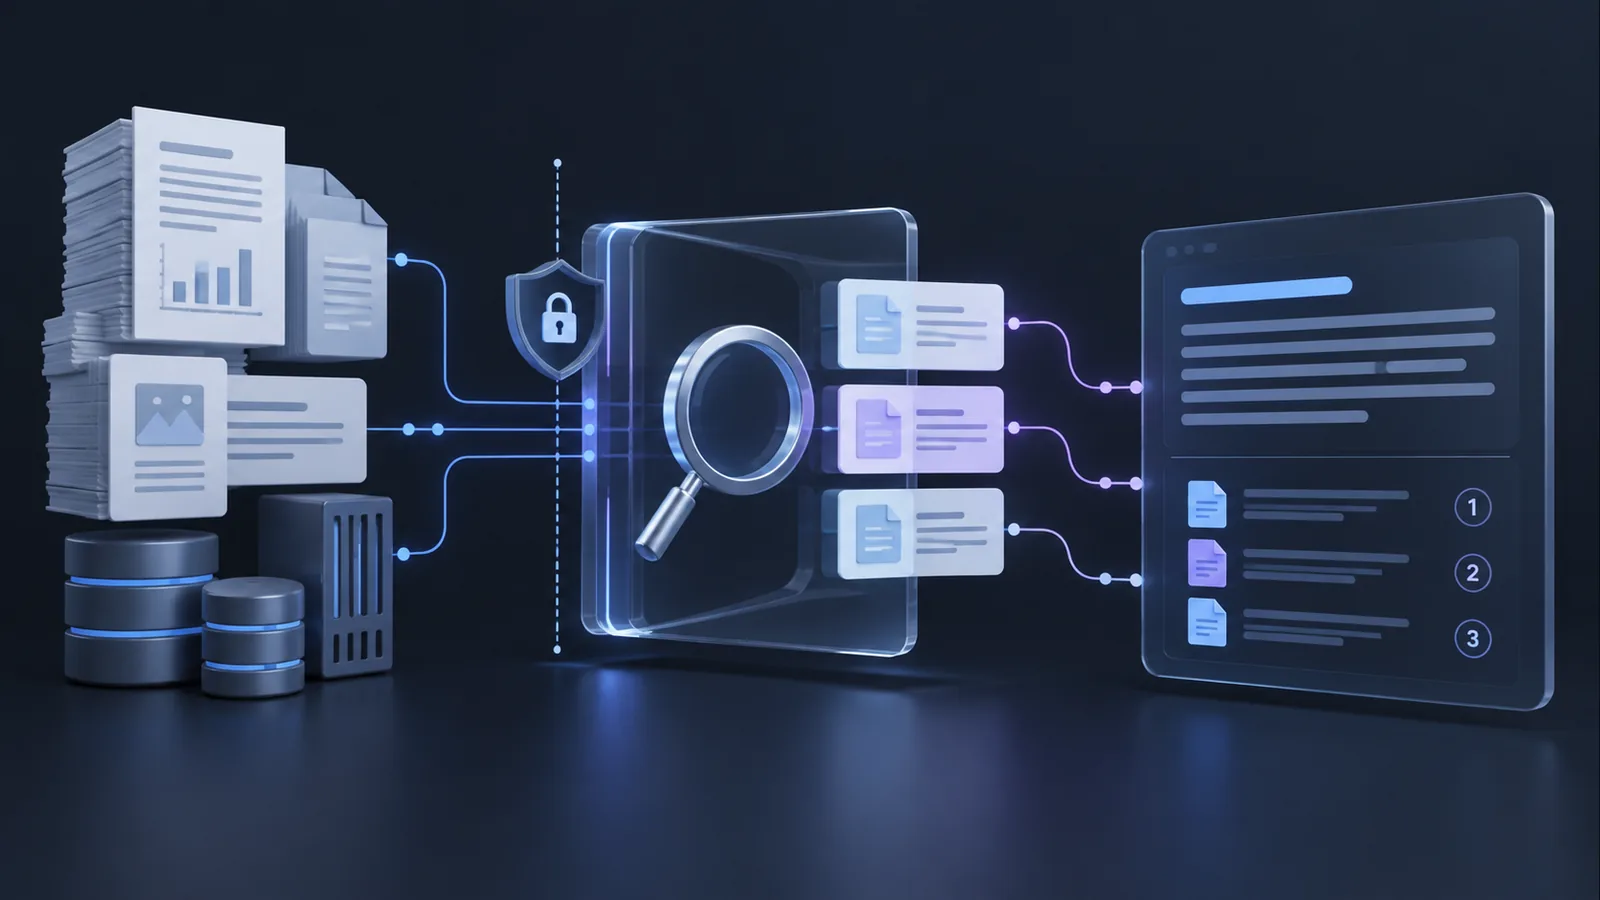
Bir RAG sistemi genellikle iki zaman diliminde çalışır: hazırlık (indeksleme) ve sorgu yanıtı. Hazırlıkta izinli kaynaklar alınır, metin anlamlı parçalara bölünür, her parçaya başlık, tarih, sahip, erişim etiketi ve kaynak bağlantısı gibi metadata eklenir. Ardından parçalar, anlam yakınlığıyla aranabilen sayısal temsillere dönüştürülür. Bu temsile yaygın olarak embedding denir. Embedding, metnin özeti veya şifresi değildir; arama için kullanılan sayısal bir gösterimdir.
Sorgu anında kullanıcının sorusu da benzer bir temsile dönüştürülür. Arama katmanı, anlamsal yakınlığa ve gerekirse anahtar kelime, tarih, belge türü ya da yetki filtresine göre aday parçaları getirir. Yeniden sıralama adımı, bu adaylar arasından soruyla en ilgili olanları seçebilir. Son aşamada seçilen parçalar ile kullanıcının sorusu dil modeline verilir. Modelden yalnızca bu kanıtlara dayanması, belirsizlikte bunu açıkça söylemesi ve kaynak bağlantılarını göstermesi istenir.
Bu akışı üç soruya ayırmak pratikte yararlıdır:
- Doğru bilgi bulundu mu? Bu, getirim kalitesi sorusudur.
- Model bulunan bilgiyi doğru yorumladı mı? Bu, yanıt kalitesi ve kanıta bağlılık sorusudur.
- Bu kullanıcı o bilgiyi görmeye yetkili miydi? Bu, erişim kontrolü ve gizlilik sorusudur.
Birinci sorun iyi, ikinci sorun zayıfsa yanıt kaynakla çelişebilir. İlk ikisi iyi, üçüncüsü zayıfsa veri sızıntısı yaşanabilir. Bu nedenle sadece kullanıcıların "cevap güzel" demesi RAG başarısını göstermez.
RAG, arama ve ince ayar arasındaki fark
| Yaklaşım | Temel işlev | Bilgi güncelleme | Kaynak gösterme | Uygun örnek |
|---|---|---|---|---|
| Klasik kurumsal arama | Belge veya sayfa bulur | İndeksi güncelleme ile | Doğrudan belge sonucu | Kullanıcı belgenin kendisini okumak istiyorsa |
| RAG | İlgili parçayı bulur, yanıtı bu bağlamla üretir | Bilgi tabanını yeniden indeksleme ile | Tasarlanırsa parça/belge düzeyinde | Politika, ürün veya süreç sorularını kaynaklı cevaplamak |
| İnce ayar (fine-tuning) | Modelin üslubunu veya görev davranışını değiştirir | Yeni eğitim ve değerlendirme gerekir | Kendiliğinden sağlamaz | Sabit biçimde sınıflandırma ya da yapılandırılmış çıktı |
| Uzun bağlamlı sohbet | Çok miktarda metni doğrudan oturuma verir | Her oturumda bağlamı yenileme ile | Bağlam verildiyse mümkün | Az sayıda belge üzerinde tekil analiz |
Uzun bağlam penceresi RAG'i otomatik olarak gereksiz kılmaz. Çok sayıda belge, değişen bilgi, erişim filtresi veya tekrarlanan sorgu varsa; hangi parçanın sunulacağını seçmek maliyet, izlenebilirlik ve kalite bakımından anlamlıdır. Buna karşılık tek bir sözleşmenin ayrıntılı incelemesinde, belgeyi doğrudan bağlama vermek daha basit olabilir. İnce ayar ise modelin davranışını değiştirebilir ama güncel şirket bilgisini denetlenebilir biçimde ekleme ihtiyacını tek başına çözmez.
Şirketler için gerçekçi kullanım alanları
RAG'in en uygun olduğu alanlar, cevabın izinli bir kurumsal kaynağa dayanmasının istendiği ve belgenin sık değişebildiği alanlardır. Örnekler şunlardır:
- Çalışan bilgi asistanı: İzin, masraf, BT destek veya iç prosedür sorularında ilgili politika maddesini ve güncellik tarihini göstermek.
- Müşteri destek temsilcisi yardımı: Ürün dokümanlarından çözüm adımı ve sürüm notu getirerek temsilcinin yanıt taslağını desteklemek.
- Satış ve teklif hazırlığı: Onaylı ürün bilgisi, teknik şartname ve sözleşme şablonlarında arama yapmak; ticari şartları otomatik kesin hüküm olarak üretmemek.
- Mühendislik bilgi erişimi: Mimari karar kayıtları, operasyon runbook'ları ve hata çözüm notlarında kaynaklı arama sağlamak.
- Uyum ve kalite: Politika, kalite prosedürü ve denetim kanıtlarına erişimi hızlandırmak; hukukî yorum veya nihai uyum kararını otomatikleştirmemek.
RAG, belgeler zaten zayıf, çelişkili veya sahipsizse bu sorunu ortadan kaldırmaz. Arama sisteminin daha hızlı getirdiği şey yanlış veya eski bilgi de olabilir. Bu nedenle ilk proje "bir sohbet botu" değil, seçili bir bilgi alanının sahipliğini, güncelliğini ve erişim kurallarını iyileştirme projesi olarak ele alınmalıdır.
Neden önemli, hangi faydaları sağlar?
RAG; modelin genel eğitim bilgisini, kuruluşun güncel ve denetlenebilir içeriğiyle tamamlamaya çalışır. Kullanıcı, yanıtın hangi belgeye dayandığını görebiliyorsa kendi doğrulamasını yapabilir. Belgeye metadata eklemek; sürüm, geçerlilik tarihi, iş birimi ve erişim düzeyi gibi sinyallerin aramada kullanılmasına olanak verir. Bilgi tabanındaki bir değişiklik ancak belge indeksi, embedding'ler ve kaynak sistemdeki erişim izinleri birlikte ve doğrulanabilir biçimde senkronize edildiğinde sonraki sorgulara güvenilir şekilde yansır; yalnızca dosyayı güncellemek eski parçaların veya eski yetkilerin sonuçlarda kalmasını engellemez.
Bunlar koşullu faydalardır. RAG çalışması, "getirilen metin" ile "üretilen yanıt" arasındaki bağın yönetilebildiğini göstermiş; model parametrelerinin dışındaki açık belleğin bilgi yoğun görevlerde kullanılabileceğini ortaya koymuştur [1]. NIST'in üretken yapay zekâ profili, RAG'i insan alan bilgisi ve iş kurallarıyla sistem performansını iyileştirmek için düşünülebilecek yöntemlerden biri olarak anmaktadır [2]. Fakat bu kaynaklar, her kurumsal RAG uygulamasının otomatik olarak doğru, güvenli veya ekonomik olduğu anlamına gelmez.
Sınırlamalar ve riskler
Getirim hatası ve kaynak dışına taşma
Modelin yanıtı iyi olsa bile arama katmanı soruyla ilgisiz parça getirebilir; bunun sonucu yanlış, eksik veya eski bilgi olabilir. Tersine, doğru parça bulunmuşken model onun desteklemediği ek bir ayrıntı yazabilir. Çözüm; cevabın yanında kaynak sunmak, yanıtı kanıtla karşılaştırmak, yeterli kanıt yoksa "bulamadım" diyebilmek ve yüksek etkili işlemlerde insan onayı koymaktır. Kaynak bağlantısı tek başına yeterli değildir: bağlantının gerçekten ilgili iddiayı desteklediği test edilmelidir.
Yetkisiz erişim ve veri sızıntısı
RAG'de erişim denetimi yalnızca sohbet ekranına girişte yapılmamalıdır. Her sorguda arama katmanı kullanıcının rolünü, iş birimini ve belge düzeyindeki izni hesaba katmalıdır. Aksi halde bir kullanıcının göremediği belge parçası, yanıt içinde dolaylı olarak açığa çıkabilir. Kişisel veri, ticari sır, erişim anahtarı veya soruşturma kaydı içeren kaynakların indekslenip indekslenmeyeceği veri sınıfına göre ayrıca kararlaştırılmalıdır.
KVKK'nın üretken yapay zekâ rehberi, üretken sistemlerin yaşam döngüsündeki kişisel veri işleme faaliyetlerini 6698 sayılı Kanun çerçevesinde ele alır [3]. RAG veri tabanının şirket içinde olması da tek başına yeterli bir hukukî veya güvenlik sonucu değildir; işleme amacı, erişim, saklama, silme, aktarım ve teknik/idari tedbirler somut senaryoya göre değerlendirilmelidir.
Prompt injection ve bilgi tabanı zehirlenmesi
RAG'e alınan belge yalnızca "veri" değildir; dil modeli bu metni komut gibi yorumlamaya zorlanabilir. Kötü niyetli ya da hatalı bir doküman "önceki talimatları yok say" gibi ifadeler içerdiğinde, sistemin davranışını değiştirmeyi hedefleyen dolaylı prompt injection ortaya çıkabilir. OWASP, bu tür saldırılarda dış bilgi tabanına zararlı yönergeler eklenmesini RAG zehirlenmesi/getirim saldırısı olarak açıklar [4]. Belge alma hattında kaynak güveni, değişiklik onayı, kötü niyetli içerik taraması, ayrılmış talimatlar ve model çıktısının araçlara doğrudan yetki vermemesi bu yüzden önemlidir.
Güncellik, telif ve bağlam sınırı
Belgenin güncel olmaması, yanlış parçaya bölünmesi veya metnin ihtiyaç duyulan istisnayı içermemesi yanıt kalitesini bozar. Ayrıca bir yanıtın kaynak göstermesi, lisans veya telif koşullarını kendiliğinden çözmez. Çok sayıda uzun parçayı modele vermek ise maliyeti artırabilir, ilgili sinyali seyreltip daha iyi sonuç garantisi vermeyebilir. RAG tasarımı; az ama ilgili, yetkili ve güncel kanıtı hedeflemelidir.
Veri güvenliği ve gizlilik için temel tasarım ilkeleri
- Veriyi sınıflandırın. Her kaynağın herkese açık, kurum içi, sınırlı veya yüksek hassasiyetli olduğunu belirleyin; sınıfı bilinmeyen içeriği otomatik indekse almayın.
- Belge düzeyinde yetkiyi koruyun. Kaynak sistemdeki rol ve grup izinlerini getirim katmanına aktarın; sadece arayüzde gizlemekle yetinmeyin.
- Minimum veriyi gönderin. Model sağlayıcısına yalnızca yanıt için gerekli parçaları iletin. Günlükler, hata kayıtları ve analitik veriler için de maskeleme/saklama kuralı tanımlayın.
- Kaynak zincirini kaydedin. Hangi belgenin hangi sürümü, hangi sorguda getirildi; ne zaman indekslendi ve kim erişti sorularını yanıtlayabilin.
- Girdi ve çıktıyı ayrı riskler olarak ele alın. Belge içeriğini, kullanıcı sorgusunu ve model yanıtını ayrı denetimlerden geçirin. Model çıktısını doğrulama olmadan kod çalıştırma, ödeme veya erişim değiştirme gibi etkilere bağlamayın.
NIST'in AI RMF yaklaşımı, yapay zekâ riskinin yaşam döngüsü boyunca yönetişim, bağlamı haritalama, ölçme ve yönetme işlevleriyle ele alınmasını önerir [5]. RAG için bunun karşılığı; veri sahibini ve kullanım bağlamını tanımlamak, değerlendirme kümesi kurmak, hata/erişim olaylarını izlemek ve risk eşiği aşıldığında sistemi sınırlandırmak veya durdurmaktır.
Maliyet ve kaynak gereksinimleri
RAG'in toplam maliyeti yalnızca dil modeli çağrısı veya vektör arama hizmeti değildir. Belge toplama, temizlik, parçalara ayırma, metadata çıkarma, embedding üretme, indeksleme, saklama, erişim entegrasyonu, gözlemlenebilirlik, değerlendirme ve insan incelemesi gerekir. Belge değiştiğinde artımlı güncelleme, silindiğinde indeksten temizleme ve erişim izni değiştiğinde yansıma süreçleri de işletim maliyetidir.
Teknik ekip için en azından veri/entegrasyon, uygulama, güvenlik ve ürün/süreç sahipliği sorumlulukları belirlenmelidir. Daha yüksek etkili alanlarda hukuk, veri koruma ve konu uzmanı da sürece katılır. Önce dar kapsamlı bir bilgi alanı seçmek; hem maliyet varsayımlarını hem de kalite ölçümünü daha güvenilir kılar.
Uygulama adımları
- Tek bir karar alanı seçin. "Tüm şirket bilgisi" yerine örneğin onaylı BT destek prosedürleri gibi sınırlı, belgeleri belli bir alanla başlayın.
- Bilgi envanteri ve sahiplik oluşturun. Kaynak belge, sahibi, sürümü, geçerlilik tarihi, veri sınıfı ve erişim grubu için kayıt tutun.
- Sorgu seti hazırlayın. Gerçek kullanım sorularından temsilî bir test kümesi oluşturun; her soru için beklenen kaynak ve kabul edilebilir yanıtın sınırını belirleyin.
- Getirim katmanını test edin. Sistem doğru parça ve doğru sürümü getiriyor mu? Kullanıcı, yetkisiz bir belgeye dolaylı yoldan erişebiliyor mu? Önce bunları ölçün.
- Yanıt kurallarını daraltın. Kaynak yoksa cevap uydurmama, kaynak gösterme, belirsizliği belirtme ve gerekli yerde insan yönlendirmesi kurallarını ekleyin.
- Korumalı pilot yürütün. Sınırlı kullanıcı grubu, okuma amaçlı kullanım, kayıt alma ve geri bildirim mekanizmasıyla başlayın. İlk sürümde işlem başlatma yetkisi vermeyin.
- İzleyin ve sürdürün. Yanıtlar, kaynaklar, hata türleri, erişim ihlali denemeleri, belge güncelliği ve maliyet düzenli gözden geçirilsin.
Karar kontrol listesi
- Kullanım sorusu, bilgi alanı ve sistem sahibi açıkça tanımlandı mı?
- Her belgenin sahibi, sürümü, geçerlilik tarihi ve erişim sınıfı var mı?
- Kaynak sistemdeki izinler, parça ve arama düzeyinde uygulanıyor mu?
- Test soruları, beklenen kanıtlar ve kabul kriterleri konu uzmanlarınca gözden geçirildi mi?
- Sistem kaynak yetersizse tahmin yürütmek yerine bunu açıklayacak mı?
- Kaynak, sorgu, erişim kararı ve yanıt için yeterli denetim kaydı tutuluyor mu?
- Prompt injection, zararlı belge ve yetki aşımı senaryoları test edildi mi?
- Belge güncelleme, silme ve izin değişikliğinin indekse yansıma süresi tanımlandı mı?
Başarı nasıl ölçülür?
RAG'i değerlendirirken getirim ve üretimi ayırmak gerekir. Getirim için "beklenen kaynak ilk sonuçlarda mı?", "yanıtı destekleyen parça getirildi mi?" ve "yetkisiz parça hiç getirildi mi?" soruları ölçülür. Yanıt için doğruluk, kaynakla desteklenme, eksik kanıtta çekimser kalma, kullanıcı tarafından anlaşılabilirlik ve gerekli eskalasyonların doğru yapılması incelenir.
Operasyonel tarafta gecikme, kullanıcı geri bildirimi, hata oranı, belge güncellemesinin yansıma süresi ve sorgu başına maliyet izlenebilir. Ancak bu metrikler kalite ve güvenliğin yerine geçmez. NIST, üretim öncesinde ve çalışma sırasında test, belgelendirme ve risk ölçümünün sürdürülmesini vurgular [5]. Ölçüm sonuçları kötüleştiğinde, örneğin doğru kaynağı getirme oranı düşerse, uygulamanın kapsamı genişletilmemelidir.
Sık yapılan hatalar ve RAG'in uygun olmadığı durumlar
En sık hata, bütün dosya deposunu filtrelemeden bir vektör indeksine aktarmaktır. Bu yaklaşım hem erişim hem de güncellik sorunlarını büyütebilir. İkinci hata, parça boyutunu ve metadata'yı test etmeden yalnızca model seçimine odaklanmaktır. Üçüncüsü, kaynak bağlantısını kalite kanıtı saymaktır; bağlantı yanlış parçaya gidiyor veya iddiayı desteklemiyorsa yanıltıcı olabilir. Dördüncüsü, modelin yanıtını doğrudan iş sistemi işlemine bağlamaktır.
RAG; güvenilir kaynak koleksiyonu yoksa, erişim modeli belirsizse, kullanıcı sorusunun yanıtı belgeye değil uzman muhakemesine veya güncel dış veriye dayanıyorsa uygun olmayabilir. Bir hukukî görüş, tıbbi tavsiye, kredi kararı veya işten çıkarma kararı; yalnızca RAG yanıtına dayanarak verilmemelidir. Aramanın tek başına yeterli olduğu durumlarda da üretken katman eklemek gereksiz risk ve maliyet yaratabilir.
Temsili kurumsal senaryo
Bu örnek temsili bir senaryodur; gerçek bir şirket vakası değildir. Bir yazılım şirketi, destek temsilcilerinin sürüm notu ve kurulum dokümanlarında arama süresini azaltmak ister. Sistem yalnızca ürün yöneticilerinin yayımladığı, sürüm etiketi ve geçerlilik tarihi olan dokümanları alır. Her parça; ürün sürümü, dil ve erişim grubu bilgisiyle indekslenir. Temsilci bir soru yazdığında sistem önce sürümü sorar veya kayıttan alır; ardından yalnızca o sürüm için uygun doküman parçalarını getirir.
Yanıt ekranı, taslak çözümün yanında kaynak başlıklarını ve bağlantılarını gösterir. Kaynak yetersizse temsilciye "bilgi tabanında doğrulanamadı" uyarısı verir; müşteriye otomatik cevap göndermez. Pilot boyunca konu uzmanları test sorularında hem getirilen kaynakları hem yanıtları işaretler. Güvenlik ekibi, farklı yetkili kullanıcıların aynı sorguda farklı sonuç görmesi gereken senaryoları dener. Bu tasarımın hedefi yalnızca hızlı yanıt değildir; doğru sürüm ve doğru yetkiyle kaynaklı destek sağlamaktır.
Sonuç
RAG, şirket bilgisini bir dil modelinin yanıt üretim sürecine bağlamanın yararlı bir yoludur; fakat kalitesi modelden önce kaynakların kalitesine, erişim kurallarına ve değerlendirme disiplinine dayanır. Sağlam bir başlangıç, dar kapsamlı ve sahipliği belirlenmiş bir bilgi alanı, kaynaklı yanıt, insan denetimi ve düzenli testtir. Sistem bu koşullarda yardımcı olur; bu koşullar yoksa hatalı bilgiye daha hızlı erişim sunma riski taşır.
Sık Sorulan Sorular
RAG nedir?
RAG, bir dil modelinin yanıt üretmeden önce ilgili belge parçalarını bulup bunları bağlama eklemesidir. Amaç, genel model bilgisini izinli ve güncel kaynaklarla tamamlamaktır.
RAG ile model eğitimi aynı şey mi?
Hayır. RAG'de bilgi genellikle sorgu anında getirilir; modelin ağırlıkları değiştirilmez. İnce ayar ise model davranışını veya görev performansını eğitim yoluyla değiştirir.
RAG halüsinasyonu tamamen önler mi?
Hayır. RAG, ilgili kanıt getirebildiğinde riski azaltmaya yardımcı olabilir; ancak yanlış getirim, eski kaynak veya modelin kaynağın dışına çıkması hâlâ mümkündür. Kaynaklı yanıt ve test gerekir.
RAG için vektör veritabanı zorunlu mu?
Hayır. Anlamsal arama için vektör indeksleri sık kullanılır, ancak anahtar kelime araması, hibrit arama veya farklı indeksleme yöntemleri de tasarıma göre kullanılabilir. Önemli olan getirim kalitesi ve erişim denetimidir.
RAG'de şirket verileri dışarı çıkar mı?
Mimariye ve kullanılan sağlayıcının veri işleme koşullarına bağlıdır. Hangi içeriğin indekslendiği, modele hangi parçanın gönderildiği, verinin nerede tutulduğu ve kimlerin eriştiği tasarım ile sözleşme düzeyinde değerlendirilmelidir.
RAG yanıtlarında kaynak göstermek neden önemlidir?
Kaynak, kullanıcının yanıtı denetlemesini ve gerektiğinde belgenin tamamını incelemesini kolaylaştırır. Yine de kaynak bağlantısının ilgili iddiayı gerçekten desteklediği ayrıca test edilmelidir.
Kurumsal RAG projesine nasıl başlanmalı?
Sınırlı ve güncel bir doküman koleksiyonu, temsilî soru seti, belge düzeyinde yetki ve insan denetimli pilotla başlanmalıdır. Tüm şirket verisini tek seferde indekslemek iyi bir ilk adım değildir.
Kaynaklar
- Lewis, Patrick; Perez, Ethan; Piktus, Aleksandra ve diğerleri — Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks. NeurIPS 2020; son arXiv sürümü 12 Nisan 2021. https://doi.org/10.48550/arXiv.2005.11401
RAG yaklaşımının üretici model ile açık, parametre dışı bilgi belleğini birleştiren temel akademik tanımını destekler. - National Institute of Standards and Technology (NIST) — Artificial Intelligence Risk Management Framework: Generative Artificial Intelligence Profile, NIST AI 600-1. 26 Temmuz 2024; sayfa 8 Nisan 2026 güncellemesi. https://doi.org/10.6028/NIST.AI.600-1
RAG'i üretken yapay zekâ performansını alan bilgisi ve iş kurallarıyla desteklemeye yönelik yöntemlerden biri olarak ele alır. - T.C. Kişisel Verileri Koruma Kurumu — Üretken Yapay Zekâ ve Kişisel Verilerin Korunması Rehberi (15 Soruda). Erişim: 27 Eylül 2026. https://www.kvkk.gov.tr/Icerik/8547/uretken-yapay-zeka-ve-kisisel-verilerin-korunmasi-rehberi-15-soruda
Üretken yapay zekâ yaşam döngüsündeki kişisel veri işleme faaliyetlerinin 6698 sayılı Kanun bağlamında değerlendirilmesini destekler. - OWASP Cheat Sheet Series — LLM Prompt Injection Prevention Cheat Sheet. Erişim: 27 Eylül 2026. https://cheatsheetseries.owasp.org/cheatsheets/LLM_Prompt_Injection_Prevention_Cheat_Sheet.html
RAG bilgi tabanına zararlı talimat enjekte edilmesi ve getirim saldırıları riskini destekler. - NIST — Artificial Intelligence Risk Management Framework (AI RMF 1.0), NIST AI 100-1. Ocak 2023. https://doi.org/10.6028/NIST.AI.100-1
Yapay zekâ sistemleri için yönetişim, bağlam haritalama, ölçüm ve risk yönetiminin yaşam döngüsü yaklaşımını destekler.